

Über uns
DCC Duisburg CityCom – Teil des DVV Konzerns
Die DCC Duisburg CityCom GmbH ist Teil der Duisburger Versorgungs- und Verkehrsgesellschaft (DVV). Zum DVV-Konzern mit rund 4400 Beschäftigten gehören beispielsweise auch die Stadtwerke Duisburg oder der Zoo Duisburg sowie über 30 weitere Gesellschaften aus den Bereichen Versorgung, Mobilität und Services, die entscheidend zur Bereitstellung einer leistungsfähigen Infrastruktur in Duisburg beitragen.
Made by DCC. Nicht eingekauft, sondern aufgebaut.
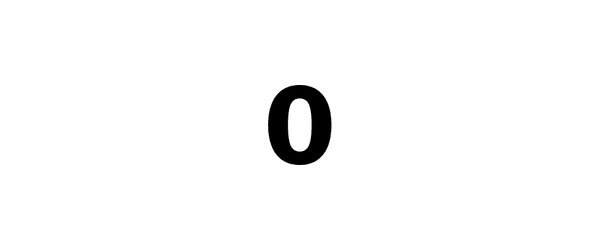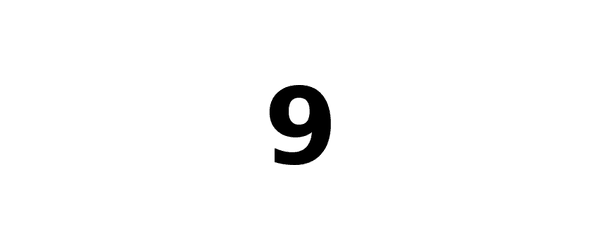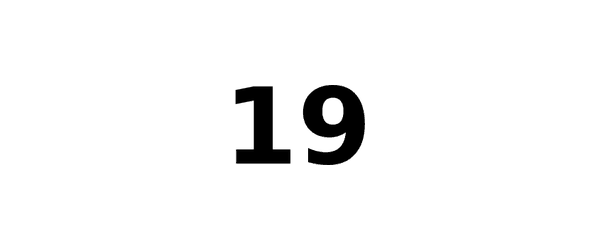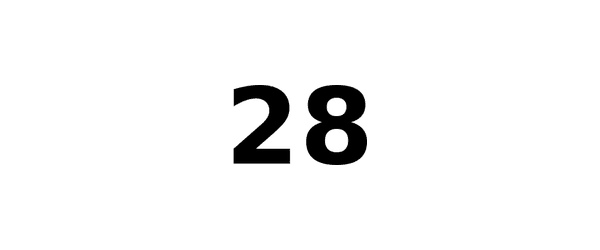
Sprints
seit Projektstart
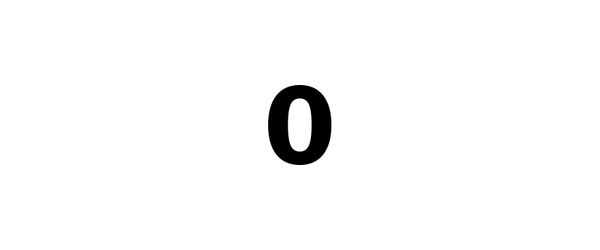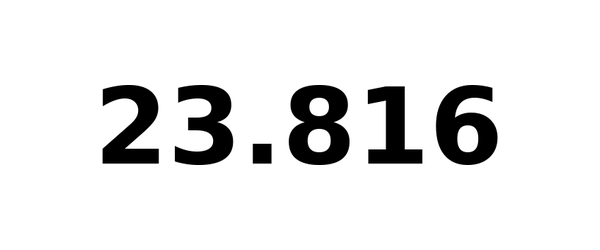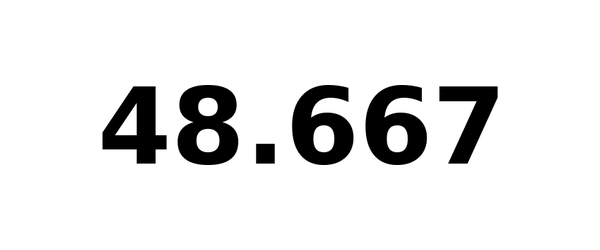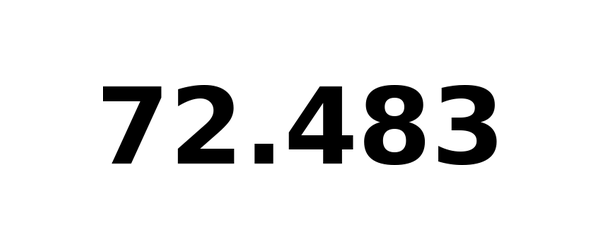
Zeilen
Code geschrieben
Agile Arbeitsweise
Unsere Vision
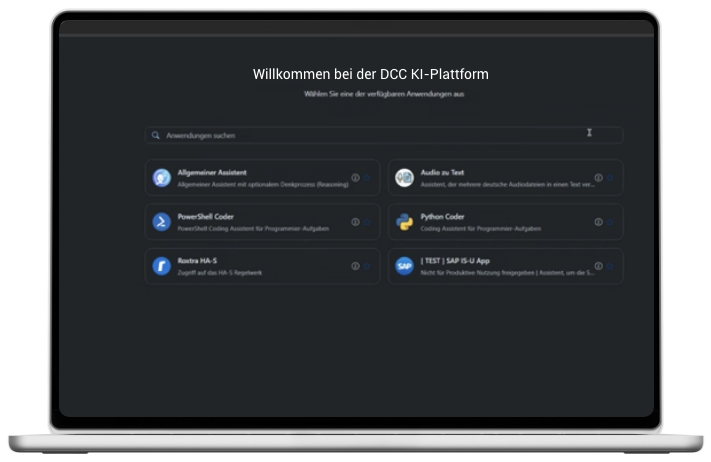
DCC KI-Plattform: Eine Plattform – Viele Einsatzbereiche
Die DCC KI-Plattform soll der zentrale Baustein für die KI-gestützte Weiterentwicklung des DVV-Konzerns, der Stadt Duisburg und weiterer Kunden werden. Geplant ist die KI auf unternehmensspezifische Themen zu trainieren: Informationen sollen aus eigenen kundenindividuellen Systemen intelligent verknüpft und kontextbasiert ausgewertet werden. Hierdurch können Mitarbeitende bei Entscheidungen im Tagesgeschäft aktiv unterstützt werden.
Unsere KI-Plattform ist interessant für Sie?
Bestens – dann nehmen Sie gleich Kontakt mit uns auf und lassen Sie uns über Ihre Vorstellungen und Ideen sprechen.
Roadmap zur KI-Plattform
01 . Kickoff
- Projekt Kick-Off mit Team und Scrum Einführung
02 . Demo & Vorbereitung
- Demo‑Vorbereitung
- Bedienoberfläche & Sidebar umgesetzt
- Branding Netze/DVV (Corporate Design)
- RAG für Word-Dokumente
- Erstellung eines Berechtigungskonzeptes
- Anbindung Verzeichnisdienste & Knowledge Navigator
03 . Anbindung & Tests
- Erste SAP IS‑U Schnittstellenanbindung (Test)
- Umsetzung von iterativen & komplexen Workflows (Workflow 1.2)
- MCP-Standard erforscht
- UX‑Prototyp & UI‑Konzept wurden entwickelt
- Follow‑up‑Fragen in RAG möglich (Kontext bleibt erhalten: sinnvolle Nachfragen/Vertiefungen möglich)
- Excel-Export aus SAP per Chat
04 . Optik, Usability, Rollout-Start
- UI/UX-Template umgesetzt sowie Dark & Light Modus eingeführt
- vLLM integriert (verbessert Geschwindigkeit und Skalierung)
- Plattform-Metriken bereitgestellt
- Einbindung von Dokumenten möglich
- Rollout erste Nutzer Netze Duisburg (ND & NW)
05 . Finetuning
- Voice-Modus implementiert (Spracheingabe)
- Mobile Ansicht (nur bei Konzern-Endgeräten)
- Neues UI‑Design ausgerollt
- Gruppenlaufwerke angebunden
- LLM‑Router implementiert (intelligente Modellwahl je Anfrage)
06 . Rollout, Nutzerbefragung & Optimierung
- Use Case Pressespiegel
- Veränderungen in Ablauf und Organisation (Anforderungsaufnahme (ASANA, LA Freigaben, Produktmanagement., interne PO-Stelle KI)
- Umfangreiche Marktanalyse
- Erste Rolloutplanungen gesamt DVV
- Gespräche mit Stadt, DVG und Octeo
- Nutzerbefragungen
07 . Rollout-Forcierung
- Vollständiger Betrieb Netze Duisburg, neue Use Cases (in Freigabe)
- Anforderungsmanagement über Demand-Prozess
- Barrierefreiheit und hands-free: Sprachausgabe mit verschiedenen Stimmen möglich
- Prüfung der KI-Plattform in den IT-Arbeitsplatz (Kosten)
- Gespräche mit DVV-Töchtern
- Prüfung des Rollouts für die Stadt Duisburg
- Rollout Stadtwerke
08 . Ausbau Vertriebsaktivitäten
- Erweiterung auf DVV-Töchter (DVG, Octeo, Kraftwerk)
- Rollout DVV-Holding (Querschnittsbereiche)
- Vertriebsstrategie aufbauen
09 . Marktöffnung
- Rollout Stadt Duisburg
- Drittmarkt: DCC KI-Plattform als Produkt für externe Kunden (erste PoC)
10 . Rollout-Erweiterung
- Prüfung weiterer Rollouts und Finalisierung der App
Funktionalitäten
Input
Wissensdatenbanken (RAG): Zentrale Verwaltung und Indexierung interner Wissensquellen
Spezifische Wissensquellen: Produktkatalog 2026, TZBD SK-D, Server Inventory Produktkatalog
Anbindung Verzeichnisdienste & Knowledge Navigator
Angebundene Systeme: Roxtra & Omnitracker
Einbindung von Dokumenten möglich
MCP-Server-Integration für Anbindung externer Dienste (z.B. M365, Asana)
Datenverarbeitung mittels LLMs: Einbindung beliebiger LLMs, strukturierte / unstrukturierte Daten
vLLM integriert: verbessert Geschwindigkeit und Skalierung
- LLM‑Router implementiert: intelligente Modellwahl je Anfrage
Output
Chat Bot:
Allgemeine Anfragen & Recherche und Uploads, Reasoning ModusEnterprise Ready:
Rollen & Berechtigungen, Logging & Auditing, Multi TenantsErstellen, Interpretation & Analyse von Grafiken
Dokumentenvergleich:
Workflow für Änderungen im Roxtra-Regelwerk, Regelwerksmanagement- Durch RAG Follow-up-Fragen möglich:
Kontext bleibt erhalten & sinnvolle Nachfragen/Vertiefungen möglich
Unser Large Language Modell (LLM) im Überblick
Kategorie, Modell und Einsatzgebiet
| MODELL KATEGORIE | BEISPIEL-MODELL | EINSATZGEBIET |
| Reasoning & Coding | GLM 4.5 Air (FP8), Qwen3-Coder | Komplexe Logik, Programmieraufgaben, Agenten-Steuerung |
| General Purpose | Qwen3.5 (397B/FP8) | Textgenerierung, Zusammenfassung, Mehrsprachigkeit, Analyse |
| Multimodal (Vision) | Qwen3-VL, FLUX.2 | Bildanalyse, OCR, Dokumentenverständnis, Bild-generierung |
| Audio (STT/TTS) | Whisper Large V3, Piper TTS | Spracherkennung, Transkription, natürliche Sprachausgabe |
Anwendungsfälle
Suchen & Wissen
Konzernregelwerk, Arbeitsanweisungen, Dokus: finden, zitieren, zusammenfassen gefiltert nach Datum (mit Verweisen & Version statt Bauchgefühl)
Systemübergreifende Recherche zu Objekt/Kunde/Anlage in einem Ergebnisbild
- Abgleichen neuer Richtlinien mit allen verfügbaren Dokumenten aus Laufwerken und internen Systemen nach Zusammenhängen, Abweichungen und Widersprüchen
Schreiben & Entscheiden
E‑Mails, Stellungnahmen, Vermerke: sauber strukturiert, im passenden Ton, auf Basis interner Vorgaben/Vorlagen
Dokumenten- & Vertragschecks gegen Compliance/Datenschutz‑Anforderungen: Abweichungen und offene Punkte
- Management‑taugliche Zusammenfassungen: „Was ist relevant? Was fehlt? Was ist die Empfehlung?“
Optimieren & Automatisieren
Interpretation & Analyse von Grafiken
Voice Mode: Diktierfunktion und Sprachausgabe der KI zum freihändigen Nutzen der mobilen App
- Nutzung von LLM-Routern, um automatisch für jede Anfrage das relevanteste LLM der Anfrage zuordnen und die Aufgabe möglichst effizient erledigen zu lassen
Unsere KI-Plattform ist interessant für Sie?
Bestens – dann nehmen Sie gleich Kontakt mit uns auf und lassen Sie uns über Ihre Vorstellungen und Ideen sprechen.
DCC KI-Plattform auf einen Blick: Sicher & unabhängig
Sicher
Souverän betrieben im eigenen Rechenzentrum der DCC – keine Datenweitergabe!
Modular erweiterbar
Architektur jederzeit durch die Anbindung von Drittsystemen ausbaubar.
Skalierbar & unabhängig
Für viele Nutzer ohne externe Abhängigkeiten.
Kompetenzaufbau
KI-Know-how wird aufgebaut und bleibt im Unternehmen.
Use-Case getrieben
Es kommt nur rein, was im Arbeitsalltag wirklich gebraucht wird.
Verlässliche Ergebnisse
Als Quellen werden interne und spezifischen Quellen aus dem Netz verwendet.
FAQs: Häufige Fragen zur unserer KI-Plattform
Betrieb und Datenverarbeitung
Die Plattform wird in unseren eigenen Rechenzentren in Deutschland betrieben. Sprachmodelle, Dokumentenverarbeitung, Wissensspeicher und alle weiteren Komponenten laufen dort. Externe Cloud- oder KI-Dienste nutzen wir nicht. Eine Ausnahme gibt es nur, wenn Sie ausdrücklich die Anbindung eines extern betriebenen Systems beauftragen.
Die Sprachmodelle selbst hat keinen Zugang zum Internet. Inhalte aus dem Internet ruft die Plattform nur über Werkzeuge (Tools) ab, die für Ihren Mandanten freigegeben sind, etwa die Websuche. Die Websuche läuft über einen Proxy, sodass die Herkunft der Anfrage nicht erkennbar ist. Die Suchbegriffe entstehen aus Ihrer Eingabe. Ob die Websuche in Ihrem Mandanten zur Verfügung steht, legen Sie fest.
Eingaben, hochgeladene Dateien und Antworten werden je Nutzer gespeichert. Andere Nutzer sehen sie nicht. Dokumente in einem gemeinsamen Wissensspeicher sehen nur die dafür berechtigten Nutzer.
Wie lange Verläufe aufbewahrt werden, ist je Workflow einstellbar; abgelaufene Verläufe löscht die Plattform automatisch.
Unser Betriebspersonal greift auf Inhalte nur zur Störungsbearbeitung oder auf Ihre Weisung zu, und solche Zugriffe werden protokolliert. Nach Vertragsende werden alle Daten gelöscht.
Nein, Ihre Daten zum Training von KI-Modellen genutzt? Wir setzen frei verfügbare Sprachmodelle mit offenen Gewichten (Open Weight) ein und trainieren sie weder noch trainieren wir sie nach. Ihre Eingaben dienen nur dazu, Ihre Anfragen zu beantworten und in Ihren Wissensspeichern zu suchen.
Ein Fine-Tuning findet nicht statt. An Ihren Einsatz angepasst wird die Plattform über Workflows, Anweisungen (System Prompts) und Ihre Wissensspeicher. Ein eigenes Modelltraining wäre technisch möglich, setzt aber einen gesonderten Auftrag voraus.
Sicherheit und Zugriffsrechte
Die Plattform schützt vor Prompt Injection über mehrere Ebenen. Die Plattform legt fest, welche Werkzeuge ein Agent im jeweiligen Anwendungsfall nutzen darf und welche Nutzer sie aufrufen dürfen. Ein Agent kann seine Berechtigungen nicht selbst erweitern. Berechtigungsprüfungen begrenzen den Datenzugriff. Schreibende Aktionen in angebundenen Systemen lassen sich an eine Freigabe durch den Nutzer binden (Human in the Loop). Zusätzlich prüfen Filter Ein- und Ausgaben auf eingeschleuste Anweisungen.
Ja, die Plattform kann Aktionen in anderen Systemen ausführen, wenn eine Schnittstelle eingerichtet ist - über eine REST API oder das Model Context Protocol (MCP). Jede Anbindung wird gesondert eingerichtet. Für schreibende Aktionen empfehlen wir die Freigabe durch den Nutzer.
Die Plattform übernimmt die Berechtigungen aus Ihrem Verzeichnisdienst, zum Beispiel für freigegebene Laufwerke. Nutzer können manuell auf User-Ebene oder über einen Verzeichnisdienst berechtigt werden. Die Berechtigung wird bei Login des Users geprüft bzw. synchronisiert.
Wissensspeicher (Buckets) sammeln Dokumente und machen sie durchsuchbar. Dazu kombiniert die Plattform eine Suche nach Bedeutung mit einer Suche nach Stichworten (Retrieval-Augmented Generation, RAG). Die Daten liegen in unseren Rechenzentren. Wer Inhalte einstellen und lesen darf, regeln Berechtigungen.
Anmeldung und Anbindungen
Die Nutzer melden sich über Ihren eigenen Identitätsprovider per OpenID Connect an – zum Beispiel Entra ID. Benötigt werden die Scopes „openid“, „profile“ und „email“. Sollen Gruppen für die Rechtevergabe genutzt werden, kommt optional „GroupMember.Read.All“ hinzu.
Name und E-Mail-Adresse, um den Nutzer zu identifizieren und ihm E-Mails zu senden. Optional die Gruppenzugehörigkeiten für die Rechtevergabe. Wie lange diese Daten gespeichert werden, legen Sie fest.
Weitere Systeme lassen sich über die REST API oder MCP anbinden. Welche Anbindungen Sie brauchen, legen wir gemeinsam mit Ihnen fest.
Ausblick
Skills & Scheduled Tasks:
Erstellung eigener Automatisierungen durch Anwender
KI as Middleware:
KI selbst als API nutzen für Automatisierung
Voll agentische Fähigkeiten:
Autonome Agenten (OpenClaw/Claude Code)
Prozessmodellierung:
Unterstützung der Geschäftsprozesserfassung (BPMN 2.0)
Schnittstellenentwicklung und -freigabe:
Anbindung konzerninterner Systeme
Geplante Features
Umsetzung Ideen-Backlog
Sicher. Integrierbar. Nachvollziehbar.
Lassen Sie uns ins Gespräch kommen!
Schreiben Sie uns einfach eine kurze Nachricht – wir melden uns bei Ihnen


Ausgezeichnet in Qualität und Sicherheit
Als DCC Duisburg CityCom bieten wir unseren Kunden beste Produkte und Services auf höchstem Sicherheits- und Qualitätsniveau. Nachweislich.